Appearance
顺序查找
2026 大纲 六(二)顺序查找法。
门槛最低的那一个
顺序查找就是从一端开始挨个比过去。它的价值不在快,而在门槛低:
它对结构的唯一要求是能逐个访问下一个元素。顺序存储、链式存储、有序、无序,全都行——这是本章唯一能用在链表上的比较型查找。
代价也很直接:每比较一次只能排除一个候选,所以 ASL 是
约定元素存放在 ST.elem[1..length],下标 0 空出不用——从表尾往前扫时"失败"正好落在 0 号位,返回值 0 天然表示失败,监视哨也是利用这个空位。
c
// 版本一:不带监视哨。每轮判两件事:i >= 1 与是否相等
int SeqSearch(SSTable ST, int key) {
    for (int i = ST.length; i >= 1; i--)
        if (ST.elem[i] == key)
            return i;
    return 0;                          // 0 号位不存数据,可安全地当作"失败"
}
先动手看一眼
有序性只优化失败查找
这是本节最要紧、也最容易记颠倒的一条。
🔴 表有序,帮的是"提前放弃",帮不了"提前找到"。 成功查找时第
个元素照样要比 次,所以有序表和无序表的成功 ASL 完全相同,都是 。
有序带来的好处只在失败那一侧:扫到某个元素已经比
c
// 有序表(升序)从表头扫,可提前终止
int SeqSearch_Ordered(SSTable ST, int key) {
    for (int i = 1; i <= ST.length; i++) {
        if (ST.elem[i] == key) return i;
        if (ST.elem[i] > key)  return 0;   // 当前元素已比 key 大,后面只会更大
    }
    return 0;                              // key 比所有元素都大
}
于是两种表的失败代价差了近一倍:
| 情况 | 无序表 | 有序表 |
|---|---|---|
| 查找成功 ASL | ||
| 查找失败 ASL | ||
| 失败情况的种数 | 1 种(扫完全表) |
有序表失败 ASL 的分子,最后一项是
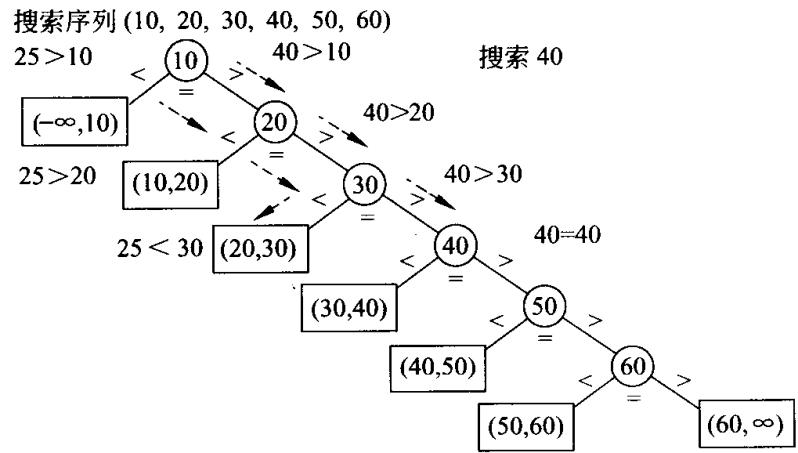
图源:殷人昆《数据结构——用面向对象方法与 C++ 描述》(第 2 版),p303 图 7.1
🔴 分子的最后一项是
,不是 。 图上看得最清楚:最右侧那个失败结点挂在第 个内部结点上,路径上只有 个内部结点。这是这个公式唯一容易算错的地方。
判定树的形态是一条单支链,每个内部结点只有一个内部孩子。这就是顺序查找效率低的图形化解释:树高等于
监视哨:省的是判断,不是比较
c
// 版本二:带监视哨。把"越界检查"用一次必然命中的数据替代掉
int SeqSearch_Sentinel(SSTable ST, int key) {
    ST.elem[0] = key;                 // 哨兵:循环最迟在 i = 0 时终止
    int i = ST.length;
    while (ST.elem[i] != key)         // 只剩一个判断条件
        i--;
    return i;                         // 返回 0 说明撞上了哨兵,即查找失败
}不带哨兵时,循环体每转一圈要做两次判断——i >= 1(是否走到头)和 ST.elem[i] == key(是否命中)。既然 elem[0] 已经等于 key,循环最迟在 i >= 1 这个判断就成了多余的。
🔴 它改的是控制流,不是比较次数。 判断次数从每轮 2 次压成 1 次,但关键字比较次数一次没少;失败查找反而多比一次(和哨兵比那一次),从
变成 。复杂度仍是 。
⚠️ 由此带出一个做题时的取值问题:无序表的失败 ASL 到底取
版本二对空表也安全:elem[0] == key 立即成立,返回 0,正确报告失败。
什么时候它反而更划算
三种场景:
很小。 折半查找每轮要算一次 mid,常数开销比"下标加一"贵;表只有几个元素时顺序扫更快。- 表频繁增删。 折半要求有序顺序存储,插一个元素要挪一片;顺序查找对结构没要求。
- 访问分布高度倾斜。 这一条最值得说,因为真题正面考过。
按查找基本概念里那条结论——把查找概率大的记录放在比较次数小的位置,ASL 最小——顺序查找就是按概率递减排列。举个能算的例子,
- 按概率递减排列:
- 等概率时的
1.9 这个数已经比同规模折半查找的 ASL 还小了。 真题有一道大题走的正是这条路:4 个元素、概率为
⚠️ 边界:只在静态表上成立,且要求概率分布已知且稳定。
逐区间求和的完整推演与两个算例(第一次学、或想手动核对公式时展开)
图中
| 失败区间 | 停在哪 | 比较次数 |
|---|---|---|
| 比第 1 个元素,发现 | 1 | |
| 比到第 2 个 | 2 | |
| 比到第 3 个 | 3 | |
| 比到第 4 个 | 4 | |
| 比到第 5 个 | 5 | |
| 比到第 6 个 | 6 | |
| 扫完全表也没遇到更大的 | 6(不是 7) |
代入公式验证:
另一个算例(
成功:查 12 比 1 次、查 25 比 2 次……查 79 比 8 次。
失败:9 个区间,前 8 个分别比
核对公式:
同一张表若按无序表处理(不利用有序性提前终止),失败 ASL 是 8 或 9——比 4.89 差了将近一倍。
监视哨版本的控制流图与实测结论(想弄清"判断次数"与"比较次数"的区别就展开)
| 指标 | 变化 |
|---|---|
| 判断次数 | 每轮 2 次 → 1 次,总数约 |
| 关键字比较次数 | 没有变少;失败查找反而从 |
| 时间复杂度 | 仍是 |
严蔚敏教材给了实测结论:表长达到 1000 以上时,监视哨版本一次查找的平均时间"几乎减少一半"。 监视哨也可以设在高下标处(此时从表头往后扫),效果对称。
链式存储上的顺序查找(题目给的是单链表时展开)
c
typedef struct LNode {
    int data;
    struct LNode *next;
} LNode;

// 带头结点的单链表上的顺序查找,返回结点指针;NULL 表示失败
LNode* ListSearch(LNode *head, int key) {
    LNode *p = head->next;        // 跳过头结点
    while (p != NULL) {
        if (p->data == key)
            return p;
        p = p->next;              // 每前进一步就是一次关键字比较
    }
    return NULL;
}
三点差别:
- ASL 完全相同:第
个结点仍需比较 次, ; - 常数因子略大:每前进一步要跟一次指针,顺序表只是下标加一;
- 设不了监视哨:单链表末尾之后没有可写的位置。真要用只能在表尾追加一个结点存
key,找到后再摘掉——通常不值得。
复杂度的逐项来历(想核对量级时展开)
| 指标 | 复杂度 | 怎么来的 |
|---|---|---|
| 最好时间 | 第一次比较就命中(目标恰好在扫描起点) | |
| 最坏时间 | 目标在扫描的另一端,或查找失败,都要走完 | |
| 平均时间 | 等概率下成功需 | |
| 空间 | 只用了循环变量 i;监视哨占用的是表内已有的 0 号位置,不算额外空间 |
"平均是
考点速记
三条结论:
- 有序性只优化失败查找——成功 ASL 有序无序都是
。 - 有序表失败 ASL 的分子是
,最后一段区间只比 次。 - 监视哨是控制流优化,不减少比较次数,失败查找反而多比一次。
这一节在 408 真题里不单独成题,但它以"组成部分"的身份出现在三处,下方「真题练习」里的题都属于这三类:
- 不等概率下重排元素求更短 ASL(大题):给 4 个元素与不等的查找概率,已知折半查找 ASL 为 2.2,要求分别在顺序存储与链式存储下给出更优方案。两问的答案都是"按概率递减排列 + 顺序查找",ASL 都算到 2.1。链式那一问的关键是:链表上根本用不了折半,所以顺序查找是唯一选择,只需把排列顺序答对。
- 分块查找的组成部分:块内查找就是顺序查找。问"块内也用顺序查找时每块多少元素效率最高",考的是分块的公式,但比较次数的来源是这一节。
- 作为"支持顺序查找"这一说法的对照:B+ 树的一个考点是"能支持顺序查找",指的是叶子结点链起来后可以顺着链扫——那是遍历意义上的顺序访问,和本节这个
的查找方法不是一回事,别把两个"顺序查找"混起来。
易错:成功 ASL 与表是否有序无关。 看到"有序表的顺序查找"就写一个更小的成功 ASL,是这类题的典型错法。
易错:有序表失败 ASL 的分子最后一项是
。 写成 会把 算成 。
易错:监视哨不减少关键字比较次数。 问"监视哨能不能降低时间复杂度",答案是不能。
教材出处
- 严蔚敏《数据结构(C 语言版)》(第 2 版)7.2.1 节「顺序查找」,p192: 顺序查找过程的定义——"从表的一端开始,依次将记录的关键字和给定值进行比较", 以及"顺序查找方法既适用于线性表的顺序存储结构,又适用于线性表的链式存储结构"; 算法 7.1 从表尾向前扫描,
ST.R[0]闲置不用。 - 同书 p193:算法 7.2「设置监视哨的顺序查找」,以及那段实测结论—— 设监视哨后"能使顺序查找在
ST.length不小于 1000 时,进行一次查找所需的平均时间 几乎减少一半",并指出"监视哨也可设在高下标处";该页同时给出与时间复杂度 。 - 插图:殷人昆《数据结构——用面向对象方法与 C++ 描述》(第 2 版)p303 图 7.1。
相关知识
查找基本概念(ASL 与判定树两件工具的最简单应用)| 折半查找(数据有序且不频繁增删时的替代)| 分块查找(块内部分就是顺序查找)| B 树(结点内查找同样是顺序查找)| 拉链法、开放定址法(绕开逐个比较,代价是失去有序性)| 单链表(链式存储上的遍历操作)