Appearance
并查集(Union-Find)
2026 大纲 四(四)2 并查集及其应用 · 本篇独立承载这一整条(双亲表示法作为一般树存储结构的完整介绍见《树与森林》,Kruskal 的完整流程见《Kruskal 算法》)。
教材出处:大纲单列了这一条,但四本主参都没有单列这一节(严蔚敏全书「并查集」零命中)。成文出处见 殷人昆《数据结构(用面向对象方法与 C++ 描述)》第 2 版 §6.2 并查集与等价类:把 n 个元素划分成一组不相交的集合、并反复查询某个元素归属于哪个集合——「适合于描述这类问题的抽象数据类型称为并查集(union-find set)。」
问题:动态连通性
要反复做两件事:把两个元素所在的集合合并,以及判断两个元素是不是同一个集合的。
集合内部的元素之间没有顺序要求,只需要有个统一的"代表"能让大家认出彼此——树天然有唯一的根,根就是天然的代表元。于是:
- 判断"是否同集合"退化成"根是否相同";
- 合并两个集合只需把一个根挂到另一个根下,一次指针修改,不用碰集合里的其他元素。
用一片森林表示不相交集合:每棵树就是一个集合。
关键的一步观察是:这个问题从头到尾只需要"往上找根",从来不需要"往下找孩子"。 所以双亲表示法是最贴合的存储——一个整型数组就够,连指针都不用。
这是"先有操作需求、后选存储结构"的典型例子:双亲表示法的短板(找孩子要扫全表)恰好是并查集一次也用不到的那一项。
两个基本操作
初始时每个元素自成一棵单结点树,森林里有
c
#define MAX 100
int parent[MAX];       // parent[i]:i 的双亲下标,根存 -1

void Init(int n) {
    for (int i = 0; i < n; i++) parent[i] = -1;
}

int Find(int x) {                    // 沿 parent 链向上找根,时间 O(h)
    while (parent[x] != -1) x = parent[x];
    return x;
}

void Union(int x, int y) {           // 挂的是两个"根",不是两个元素
    int rx = Find(x), ry = Find(y);
    if (rx == ry) return;            // 已在同一集合,什么也不做
    parent[rx] = ry;
}
Union 的对象是根,这一点务必写对。 直接写 parent[x] = y 是错的——那会把
根有三种约定,做题时看清题面用的是哪种:
parent[root] = -1(本篇正文用这种);parent[root] = root指向自己(找根循环写成while (parent[x] != x),不用判负);parent[root] = -size存集合元素个数的相反数(顺带得到集合大小,教材插图用的是这种)。
朴素实现会被卡成一条链
上面那个 Union 有个明显的问题:它完全不看两棵树的规模,总是把"前者的根"挂到"后者的根"下。于是一棵高树可能被挂到一个单结点下面,高度加 1。
下面这个操作序列就能把它卡到最坏:
Init(n) 后依次执行: Union(0,1), Union(1,2), Union(2,3), ..., Union(n-2, n-1)

第 1 步 Union(0,1):parent[0]=1        第 2 步 Union(1,2):parent[1]=2
        1                                      2
        |                                      |
        0                                      1
                                               |
                                               0
   ...
最终形成一条长度为 n 的链:  n-1 ← n-2 ← ... ← 1 ← 0
此后每次 Find(0) 都要走 Find 与 Union 都退化成
修好它有两条独立的思路,而且互不冲突、可以同时用:
- 别让树长高:合并时看清两棵树的规模,让小的挂到大的下面 → 按秩合并 / 按规模合并;
- 走过就把路铺平:既然
Find已经走了一趟,顺手把这一路上的结点全部直接挂到根上 → 路径压缩。
优化一:按秩合并——不让树长高
记住每棵树的高度上界(称为秩),合并时矮树挂到高树下:
c
int rank_[MAX];        // 秩:以 i 为根的树的高度上界(rank 是 C++ 库里的名字,故加下划线)

void Union_Rank(int x, int y) {
    int rx = Find(x), ry = Find(y);
    if (rx == ry) return;
    if (rank_[rx] < rank_[ry]) parent[rx] = ry;
    else if (rank_[rx] > rank_[ry]) parent[ry] = rx;
    else { parent[ry] = rx; rank_[rx]++; }   // 只有等高合并才让高度 +1
}
定理:按秩合并后任一棵树的高度
证一个更强的引理:秩为
于是任一棵树的结点数
注意这是最坏复杂度,不是摊还的——每一次操作都有这个保证。 从证明还能看出一件事:秩只在"两棵等高树合并"时才增加,而这需要结点数翻倍,所以秩增长得非常慢——
按规模合并(union by size)是等效的另一种做法:比较元素个数而不是树高,让元素少的树挂到元素多的树下。它的理由更直观:一个结点的深度只有在它所在的树被挂到另一棵不小于它的树下时才增加 1,而这会让它所在集合的规模至少翻倍;规模从 1 翻到
按规模合并的"根存负数"写法与教材插图(题面把根存成负数时展开)
把根的 parent 直接存成"集合元素个数的相反数",一个数组同时兼任两职:
c
int parent[MAX];   // 非根:存双亲下标(非负);根:存 -(集合元素个数)

void Init(int n) {
    for (int i = 0; i < n; i++) parent[i] = -1;   // 每个集合 1 个元素
}

int Find(int x) {
    while (parent[x] >= 0) x = parent[x];         // 负数即为根
    return x;
}

void Union(int x, int y) {
    int rx = Find(x), ry = Find(y);
    if (rx == ry) return;
    if (parent[rx] > parent[ry]) {                // 注意是负数:值大 = 规模小
        parent[ry] += parent[rx];
        parent[rx] = ry;                          // 小的挂到大的下面
    } else {
        parent[rx] += parent[ry];
        parent[ry] = rx;
    }
}比较方向容易写反:存的是负数,所以
parent[rx] > parent[ry]表示 rx 的集合更小。把它读成"绝对值小的挂到绝对值大的下面"就不会反。
额外收益:求"某元素所在集合有多少个元素"变成 -parent[Find(x)])。
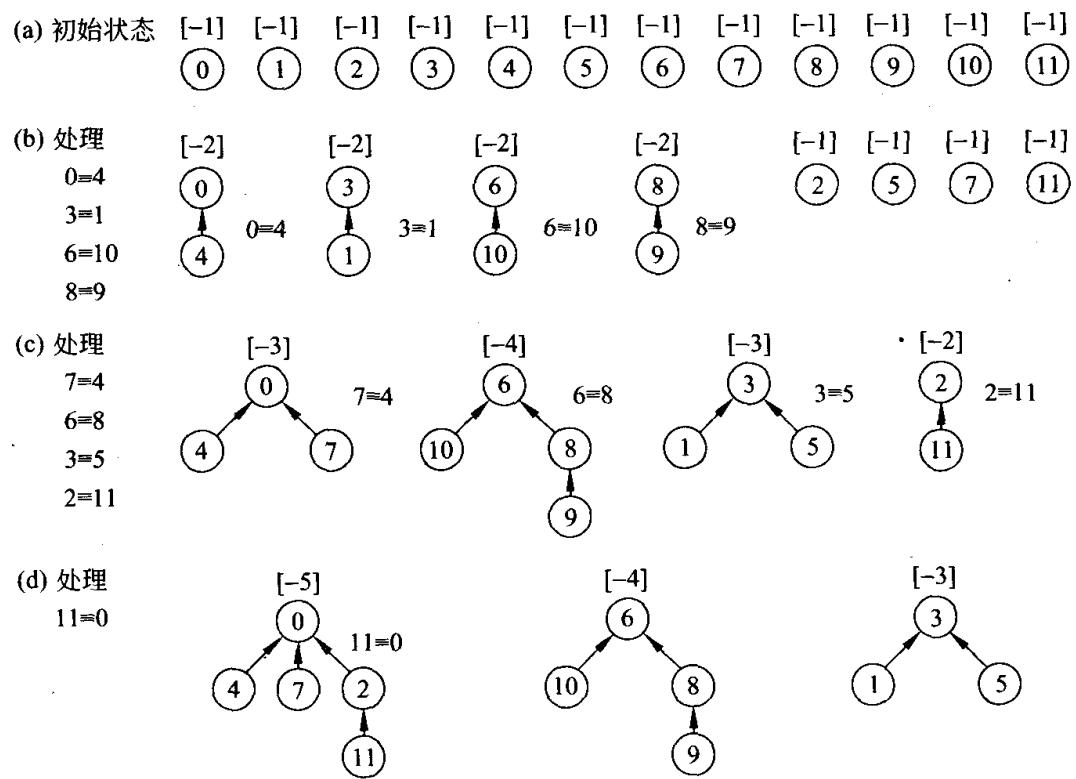
上图从 12 个各自独立的单元素集合出发,逐批处理等价对:(a) 是初始状态,每个根都标着
;(b) 处理 4 对不相交的等价关系,各自形成 的两元素集合;(c) 继续处理时开始出现"树挂到树下",根上的计数变成 、 ;(d) 处理最后一对时,规模为 2 的那棵树整体挂到了规模为 3 的树下,得到 。 注意图中根结点存的是"集合元素个数的负值",与本篇正文统一采用的"根存 "是两种不同的约定。 图源:殷人昆《数据结构——用面向对象方法与 C++ 描述》(第 2 版)图 6.10,p268
优化二:路径压缩——走过就把路铺平
c
// 递归版:递归找根,返回途中顺手把 x 直接挂到根上
int Find_PC(int x) {
    if (parent[x] == -1) return x;
    parent[x] = Find_PC(parent[x]);
    return parent[x];
}

// 迭代版:无递归栈开销
int Find_PC2(int x) {
    int root = x;
    while (parent[root] != -1)     // 第一趟:先找到根
        root = parent[root];
    while (x != root) {            // 第二趟:把路径上的结点全部改挂到根
        int next = parent[x];      // 先存好原来的双亲,否则改了就找不到了
        parent[x] = root;
        x = next;
    }
    return root;
}
压缩前 执行 Find(4) 之后
0 0
| / /| \
1 1 2 3 4 ← 路径上的 1、2、3、4 全部直接挂到根 0
|
2
|
3
|
4关于路径压缩必须理解的三点:
① 它只改 Find 路径上结点的 parent,这些结点本来就在同一集合里,集合的划分丝毫未变,只是树被压扁;旁支上的结点完全不受影响。 ② 单次 Find 不会因压缩而变慢,额外工作量与这趟路径的长度同阶。 ③ 压缩后 rank 不再等于真实树高、只是一个上界——精确维护它要重扫整棵子树,代价太大,而上界已足够支撑复杂度结论。
复杂度:分清"最坏"与"摊还"
| 实现方式 | Find / Union | 复杂度类型 | 依据 |
|---|---|---|---|
| 朴素(无优化) | 最坏 | 可被"依次 Union(i-1,i)"卡成一条长链 | |
| 仅按秩 / 按规模合并 | 最坏,每次都有硬保证 | 秩为 | |
| 仅路径压缩 | 摊还,单次仍可能 | 长链被压平一次后不再重现,代价被后续操作分摊 | |
| 路径压缩 + 按秩合并 | 摊还 | 经典结果, |
"摊还"的准确含义:
两者的区别一句话:按秩合并给的是"每一次"都不超过
的硬保证;路径压缩给的是"平均到每次操作"不超过 。
空间都是 parent[];按秩合并另加 rank[],按规模合并可把规模塞进 parent[] 的负数里。
手算演示:parent 数组的逐步变化(想练手工模拟时展开)
初始集合 Union(0,1)、Union(2,3)、Union(1,3)、Union(0,4):
| 操作 | parent[0] | parent[1] | parent[2] | parent[3] | parent[4] |
|---|---|---|---|---|---|
| 初始 | -1 | -1 | -1 | -1 | -1 |
| Union(0,1) | 1 | -1 | -1 | -1 | -1 |
| Union(2,3) | 1 | -1 | 3 | -1 | -1 |
| Union(1,3) | 1 | 3 | 3 | -1 | -1 |
| Union(0,4) | 1 | 3 | 3 | 4 | -1 |
此时 Find(0) 需要走 3 步(Find(0):
压缩前              执行 Find(0) 之后
     4                    4
     |                  / | \
     3                 3  1  0      ← 路径 0→1→3→4 上的 0、1、3 全部直挂到根 4
    / \                |
   1   2               2
   |
   0
parent[0] 由 1 变为 4、parent[1] 由 3 变为 4、parent[3] 保持 4、parent[2] 不变(它不在这次 Find 的路径上)。集合成员一个没变,仍是
典型应用
1. Kruskal 算法中的判环。 Kruskal 按权值从小到大考察每条边,需要判断"加入这条边会不会形成回路"——等价的问法是这条边的两个端点是不是已经连通了,正好是并查集的查询操作。
依次取权值最小的边 Find(u) 与 Find(v):两个根不同说明尚未连通,选中该边并 Union(u,v);两个根相同说明加入会成环,跳过。选够
这里体现了并查集不可替代的价值:如果每次都用 DFS/BFS 判连通,单次就是
2. 等价类划分。 每读入一对等价关系 Union(a,b);全部处理完后,Find 值相同的元素属于同一等价类。
并查集恰好适配等价关系,因为三条性质一一对应:自反性对应"初始化时每个元素自成一集";对称性对应"Union 与查询都不区分参数次序";传递性对应"合并后三者同根"。
3. 连通分量计数。 初始把计数器置为 Union(两个根不同)让计数器减 1。处理完所有边后计数器的值就是连通分量个数——为 1 则图连通;若某次 Union 时两端点的根已相同,说明存在回路。
并查集做不到什么:删除元素、把集合拆开、枚举某个集合的所有元素、求两个集合的交集——原因都是同一个,双亲表示法只存向上的边,找孩子是
一句话:并查集只回答"是不是一伙的",不回答"这一伙都有谁"。 需要后者时得另开一个数组或链表来记。
考点速记
三条会被反复调用的结论:
- 森林是这个问题的正确建模:根天然是代表元,判同集合退化成判根相同、合并只需一次指针修改;全部操作只往上走,所以选双亲表示法。
- 两项优化各治一半:按秩 / 按规模合并不让树长高(最坏
的硬保证),路径压缩把走过的路铺平(摊还 ),两者兼用摊还 。 - 路径压缩只改这一趟路径上结点的双亲指向,集合的划分丝毫未变,
rank也因此退化为上界。
这一节至今在 408 真题里不单独成题(所以下方「真题练习」是空的,不是漏挂),但它以工具的身份出现在最小生成树的题里。
Kruskal 的两道真题——一道选择题问"加入最小生成树的边依次是哪些",一道大题要求给出光缆铺设方案——做题时逐边判断"两端点是否已连通",用的正是并查集的思路,只是手算时不必真的写出 parent 数组,画出当前已选的边看看会不会成环即可。
不过大纲把「并查集及其应用」单列为四(四)2,它随时可能被直接考。真要出,最可能的两种形态是:
- 模拟题:给一串
Union操作,问最终的parent数组或某次Find走了几步。逐步画树最稳,注意看清题面用的是哪种根约定,以及有没有要求按秩合并 / 路径压缩。 - 复杂度辨析题:选项会把"最坏"和"摊还"混着摆。记住那张表的两行——只按秩合并是最坏
,带路径压缩的都是摊还复杂度。
易错:
Union写成parent[x] = y而不是parent[Find(x)] = Find(y)。 那会把从原来的树里拽出来。
易错:把
当成单次最坏。 它是摊还结果,单次仍可能更慢。
易错:认为路径压缩会改变集合的划分。 它只压扁树,成员一个不变。
易错:按规模合并时把负数的比较方向写反。 值大
规模小。
教材出处
- 双亲表示法的结点形式与"这种存储结构利用了每个结点(除根以外)只有唯一的双亲的性质。在这种存储结构下,求结点的双亲十分方便,也很容易求树的根,但求结点的孩子时需要遍历整个结构"——这正是并查集选用双亲表示法的全部理由:严蔚敏《数据结构(C 语言版)》(第 2 版)印刷 p133(5.6.1 节)
- 森林的定义"是
( )棵互不相交的树的集合。对树中每个结点而言,其子树的集合即为森林":印刷 p113(5.1.2 节) - 插图见上文「按规模合并」折叠块,取自殷人昆《数据结构——用面向对象方法与 C++ 描述》(第 2 版)p268
说明:严蔚敏这本教材没有并查集的专门章节,因此本篇正文只能引到它的双亲表示法一节;插图取自殷人昆那一本的并查集示例。其余推导(按秩合并的
下界、按规模合并的深度上界、摊还复杂度的辨析)为本文自行给出的证明,故不标页码。
相关知识
树与森林(双亲表示法的完整介绍与三种一般树存储结构的对比)|Kruskal 算法(判断加边是否成环,并查集在真题里的实际出场)|图的基本概念(连通分量的定义)|哈夫曼树(同样是反复合并森林中的树,但合并规则由权值决定)|树与二叉树基本概念