Appearance
堆排序
2026 大纲 七(八)堆排序(堆这个数据结构本身——定义、上浮下沉、插入删除、优先队列、Top-K——见《堆》,本篇只讲排序流程与排序视角的性质)。
把上一趟的比较结果存下来复用
简单选择排序慢在哪?每趟都把未排序区从头扫到尾,上一趟辛苦比出来的大小关系一点没用上。
堆排序的改法是:把胜负关系存进一棵树里。这样每选出一个最值,只需沿一条路径调整,每趟比较次数从
流程分两段:先建一个大根堆,然后反复"堆顶与当前末元素交换、把前段重新调成堆"。
一趟之后的不变量是:
尾部
个是全局最大的 个、已升序且永不再动;前 个仍是一个合法的大根堆。
为什么非要与末元素交换? 因为这一步同时完成两件事:腾出堆顶、让最大值归位——一个额外单元都不用。这正是堆排序空间
下标约定:本篇用 1 起——左孩子
、右孩子 、双亲 、最后一个非终端结点 。0 起则依次为 、 、 、 。全程只用一套,别混。
先动手看一眼
代码与四处不能改的地方
c
// A[1..n] 存数据;假设 A[s+1..m] 已是堆,把 A[s..m] 调整为以 A[s] 为根的大根堆
void HeapAdjust(int A[], int s, int m) {
    int rc = A[s];                       // 暂存待筛选的记录,全程只搬它一次
    for (int j = 2 * s; j <= m; j *= 2) {// j 指向 s 的左孩子,沿路径向下
        if (j < m && A[j] < A[j + 1])
            j++;                         // j 指向左右孩子中较大的那个
                                         // j < m 保证右孩子存在,不越界
        if (rc >= A[j])
            break;                       // 已满足堆序,rc 就该待在位置 s 上
        A[s] = A[j];                     // 较大的孩子上移
        s = j;                           // 下降到该孩子的位置,继续
    }
    A[s] = rc;                           // 待筛记录落位
}

void BuildMaxHeap(int A[], int n) {
    for (int i = n / 2; i >= 1; i--)     // 从最后一个非终端结点倒推到根
        HeapAdjust(A, i, n);             // 倒着做才保证 A[i+1..n] 已满足堆序
}

void HeapSort(int A[], int n) {
    BuildMaxHeap(A, n);
    for (int i = n; i > 1; i--) {        // 共 n-1 趟
        int x = A[1]; A[1] = A[i]; A[i] = x;  // 堆顶与未排序区末元素交换,A[i] 就位
        HeapAdjust(A, 1, i - 1);         // 把 A[1..i-1] 重新调整为大根堆
    }
}
🔴 第一,建初堆必须从
倒着做。 HeapAdjust的前提是"A[s+1..m]已是堆",倒序恰好保证处理结点时它的两棵子树(根为 、 )已处理过;正着来前提不成立,一趟调不出堆。序号大于 的都是叶子,必已成堆,不必处理。
第二,j < m 不能省:j == m 时结点 j 没有右兄弟,读 A[j+1] 就越界。
第三,用"上移 + 最后落位"而不是每步交换:交换要 3 条赋值,这里每步只写 1 条,最后补一次 A[s] = rc。
第四,步进是 j *= 2:循环体末尾 s 已被赋成 j,故 j *= 2 恰好指向新的左孩子。若 2*s > m(s 是叶子),循环一次都不进,直接还原,正确。
手工建堆:倒着来,逐个下沉
真题给一个初始序列和四个"建大根堆的序列变化过程",问哪个正确。关键全在建堆的次序上,所以手工建堆的流程必须走熟:
- 找到最后一个非终端结点
,从它开始; - 对当前结点做一次下沉:与左右孩子中较大的那个比,比它小就换下去,继续往下比,直到满足堆序或到达叶子;
- 结点号减 1,回到第 2 步,直到处理完根结点。
拿
| 步 | 处理结点 | 值 | 孩子 | 动作 | 结果 |
|---|---|---|---|---|---|
| 1 | 3 | 5 | 较大孩子 7 | 6 1 7 9 8 4 5 | |
| 2 | 2 | 1 | 较大孩子 9 | 6 9 7 1 8 4 5 | |
| 3 | 1 | 6 | 较大孩子 9 | 9 8 7 1 6 4 5 |
最终大根堆:9 8 7 1 6 4 5。
这类题的三个排除点:
- 起点必须是
,不是根、也不是 。 从根开始往下建是错的。 - 每一步只处理一个结点,且结点号严格递减。 选项里若出现"先调 2 号再调 3 号"这种顺序反了的,直接排除。
- 下沉要走到底。 一个结点换下去之后,如果新位置还有孩子且不满足堆序,本步要继续往下换完,不能算作下一步。第 3 行的 6 连换两次就是这种情况——有的错误选项会把它拆成两步,从而多出一个中间状态。
建初堆是
🔴 直觉上"
个非终端结点,每个筛选 "给出 ,但这个估计太松:绝大多数结点位于树的底层,能下降的距离很短。
设
即
对照能把道理说透:若改用"从空堆开始逐个插入并上浮"建堆,代价是
。上浮距离由结点到根的距离决定,而大多数结点离根很远;下沉距离由到叶的距离决定,而大多数结点离叶很近。 两种建堆方式的复杂度差别,根子就在这一句上。
排序阶段是
总计
三个"唯一":最坏有保证、空间真
最好、最坏、平均完全相同,都是
空间真正是 rc,与 HeapAdjust 写成循环;写成递归就变
🔴 它是唯一同时做到"最坏
"与"空间 "的比较排序。 二路归并排序有同样的时间保证但要 辅助数组;快速排序空间较小但要 的递归栈且最坏会退化。三者各缺一角,堆排序缺的是稳定性和常数因子。
只能用于顺序表。 全程依赖"由下标
适用与不适用:
建初堆与逐趟排序的完整推演(第一次学、或想手动模拟就展开)
以 {49, 38, 65, 97, 76, 13, 27, 49*} 为例(49* 是第二个 49)。
| 结点值 | 孩子 | 动作 | 结果 | |
|---|---|---|---|---|
| 4 | 97 | A[8] = 49* | 49 38 65 97 76 13 27 49* | |
| 3 | 65 | A[6] = 13, A[7] = 27 | 较大孩子 27, | 49 38 65 97 76 13 27 49* |
| 2 | 38 | A[4] = 97, A[5] = 76 | 较大孩子 97 A[8] = 49* | 49 97 65 49* 76 13 27 38 |
| 1 | 49 | A[2] = 97, A[3] = 65 | 较大孩子 97 A[4]=49*、A[5]=76,较大是 76 | 97 76 65 49* 49 13 27 38 |
初始大根堆:97 76 65 49* 49 13 27 38,对应的完全二叉树:
              97(1)
           /        \
       76(2)        65(3)
      /    \       /    \
   49*(4)  49(5) 13(6)  27(7)
   /
 38(8)
逐个验证堆序:
排序阶段(粗体为已就位部分):
| 趟 | 交换 | 交换后 | 筛选后(新的堆 + 已就位部分) |
|---|---|---|---|
| 1 | A[1]↔A[8] | 38 76 65 49* 49 13 27 97 | 76 49* 65 38 49 13 27 97 |
| 2 | A[1]↔A[7] | 27 49* 65 38 49 13 76 97 | 65 49* 27 38 49 13 76 97 |
| 3 | A[1]↔A[6] | 13 49* 27 38 49 65 76 97 | 49* 49 27 38 13 65 76 97 |
| 4 | A[1]↔A[5] | 13 49 27 38 49 65 76 97* | 49 38 27 13 49 65 76 97* |
| 5 | A[1]↔A[4] | 13 38 27 49 49 65 76 97* | 38 13 27 49 49 65 76 97* |
| 6 | A[1]↔A[3] | 27 13 38 49 49 65 76 97* | 27 13 38 49 49 65 76 97* |
| 7 | A[1]↔A[2] | 13 27 38 49 49 65 76 97* | 13 27 38 49 49 65 76 97* |
每一趟结束后都可以自查两件事:尾部就位的元素是否单调递增,前部是否仍是合法大根堆。
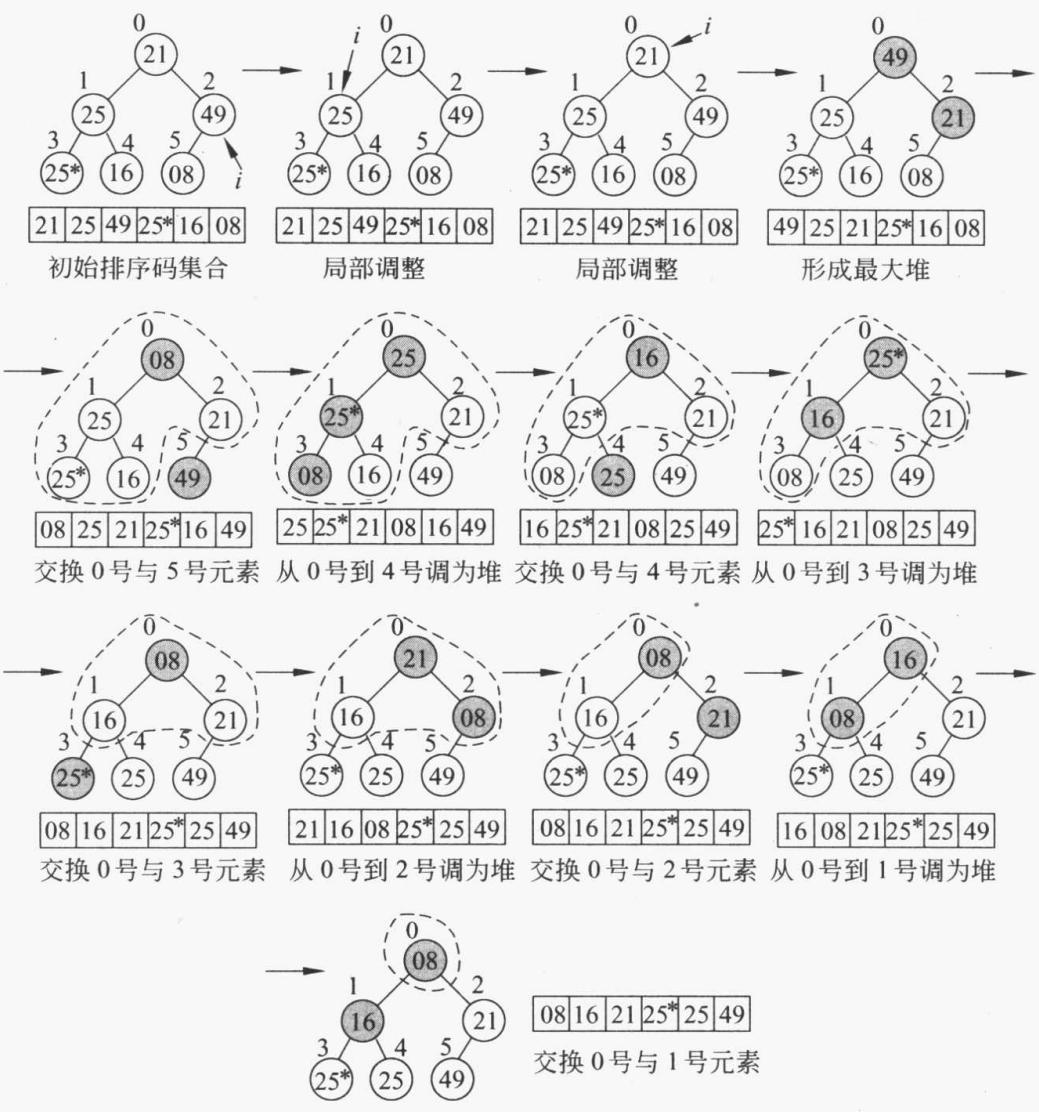
图源:殷人昆《数据结构——用面向对象方法与 C++ 描述》(第 2 版)图 9.17 堆排序的示例,p421
⚠️ 该图的结点编号从 0 起(根是 0 号),与本篇正文的 1 起编号相差 1,对照时注意换算。
不稳定的反例逐步推演(想看清两个相等元素是怎么被换过去的就展开)
{21, 25, 49, 25*, 16, 08}(25* 是第二个 25,初始时排在 25 后面),按 1 起下标 A[1..6]:
| 阶段 | 数组状态 |
|---|---|
| 初始 | 21 25 49 25* 16 08 |
| 建初堆( | 49 25 21 25* 16 08 |
第 1 趟:A[1]↔A[6],筛选 | 25 25* 21 08 16 49 |
第 2 趟:A[1]↔A[5],筛选 | 25* 16 21 08 25 49 |
第 3 趟:A[1]↔A[4],筛选 | 21 16 08 25 25 49* |
第 4 趟:A[1]↔A[3],筛选 | 16 08 21 25 25 49* |
第 5 趟:A[1]↔A[2] | 08 16 21 25 25 49* |
最终 25* 排在了 25 前面——初始时 25 在前,次序被颠倒。
根源:第 1 趟把堆顶 49 与末元素 08 交换后,08 从位置 6 一步跳到位置 1,随后的筛选又把 25、25* 各挪了位置——两个相等元素在这一连串远距离搬动中从未被直接比较过(它们不是父子关系,堆序也不要求兄弟或跨子树之间有序)。与快速排序、简单选择排序、希尔排序的不稳定根源完全一致。
复杂度汇总与两处易混对照
| 指标 | 结果 | 说明 |
|---|---|---|
| 建初堆 | 大多数结点在底层,下沉距离短 | |
| 排序阶段 | ||
| 最好 / 最坏 / 平均 | 均为 | 对任意输入的保证 |
| 空间 | 循环式筛选,无辅助数组、无递归栈 |
| 对比项 | A | B | 判别依据 |
|---|---|---|---|
| 建初堆的复杂度 | 自底向上下沉: | 逐个插入上浮: | 下沉距离由到叶的距离决定,上浮由到根的距离决定 |
| 堆有序 vs 完全有序 | 堆只保证"双亲优于孩子" | 有序要求处处相邻有序 | 左右孩子之间、同层之间、跨子树之间都不要求有序;升序数组是合法小根堆 |
考点速记
三条结论:
- 建初堆从
倒着做,代价 而不是 。 - 最好、最坏、平均都是
,是对任意输入的保证。 - 唯一同时做到"最坏
"与"空间 "的比较排序,缺的是稳定性。
这一节在真题里被考过的形式(下方「真题练习」逐题对应):
- 建大根堆的序列变化过程:给初始序列和四个变化过程,选正确的那个。三个排除点:起点必须是
(不是根)、结点号严格递减、一个结点要一次下沉到底(错误选项常把连续两次下沉拆成两个中间状态)。 - 稳定性判断:不稳定,与希尔、快排同列(详见排序算法对比)。
它还会作为对照项出现在几处:与冒泡排序的中间状态区分(尾部一模一样,只能看前部有没有堆序);"每趟至少确定一个元素最终位置"的判断(堆排符合)。
易错:建初堆是
。 写成 是把上浮式建堆的代价套过来了。
易错:空间
的前提是筛选写成循环。 题目给的是递归版时,空间是 。
易错:堆排与冒泡的中间状态尾部一致。 判断时看前部是否满足
且 ——堆排必满足,冒泡一般不满足。
教材出处
- 堆的定义(
且 , )、大根堆与小根堆、堆排序的三步流程(建初堆 → 交换 与 → 重新调整):严蔚敏《数据结构(C 语言版)》(第 3 版),p304–p305 - 筛选法调整堆的算法步骤与算法描述(算法 8.7
HeapAdjust):同书 p306 - 建初堆的算法(算法 8.9,"所有序号大于
的结点都是叶子,只需从最后一个分支结点 开始,依次将序号为 、 、…、1 的结点作为根的子树都调整为堆")、堆排序算法(算法 8.9)、以 为例的建堆过程(图 8.11)与排序过程(图 8.12):同书 p306–p308 - 建初堆总比较次数不超过
、重建堆时总比较次数不超过 、最坏情况时间复杂度 、"实验研究表明,堆排序的平均性能接近于最坏性能"、空间复杂度 :同书 p307–p308 - 算法特点:"是不稳定排序";"只能用于顺序结构,不能用于链式结构";"初始建堆所需的比较次数较多,因此记录数较少时不宜采用。堆排序在最坏情况下时间复杂度为
,相对于快速排序最坏情况下的 而言是一个优点":同书 p309 - 树形选择排序(锦标赛排序)作为堆排序的前身、以及"改进简单选择排序应从如何减少比较出发"的动机:同书 p302–p303
- 图 9.17 堆排序的示例(含两个相等关键字 25 与 25*,结点编号从 0 起):殷人昆《数据结构——用面向对象方法与 C++ 描述》(第 2 版),p421
相关知识
堆(结构本身与