Appearance
B+ 树
2026 大纲 六(六)B+ 树的基本概念(B 树及其基本操作见《B 树》)。
一个改动,推出全部差异
B 树已经把树高压到很低了,但它还剩两个痛点。
痛点一:数据散布在所有层。 要按顺序取出一段区间里的全部关键字,只能做中序遍历——在树里反复上下移动,每上下一次就是一次磁盘 I/O。
痛点二:内部结点既存索引又存数据。 一条记录动辄上百字节,塞进内部结点会挤占关键字的位置,扇出变小、树反而变高。
B+ 树的改动只有一条:把全部关键字连同数据一起下沉到叶结点,非叶结点只留索引副本,再把叶结点串成一条有序链表。 这一条改动推出了它与 B 树的所有结构差异,下面的每一条都能从它导出来。
关键字从"分隔者"变成了"标签"
先看定义,
- 每个内部结点最多
棵子树; - 根结点至少 2 棵子树(除非整棵树只有一个叶结点);
- 除根外的内部结点至少
棵子树; - 🔴 内部结点的关键字个数 = 子树个数;
- 所有叶结点在同一层,且包含全部关键字以及指向数据记录的指针;
- 叶结点之间通过顺序指针链接成一条有序链表。
第 4 条是最容易和 B 树记混的地方(B 树是"关键字数 = 子树数
B 树里的
是一个真实存在的记录,它把左右两棵子树分隔开—— 个分隔者切出 段,所以有 棵子树。 B+ 树里的 只是索引副本,是第 棵子树中最大关键字的复写——一棵子树配一个标签,所以两者相等。
记住"分隔者 vs 标签"这个理由就不会记混。它同时解释了另一条差异:B+ 树的关键字会在内部结点重复出现(叶子里有一份、上层索引里还有一份),而 B 树里每个关键字只出现一次。
由第 4 条和第 3 条合起来,非根内部结点的关键字个数范围是
说明:上面用的是「最大关键字复写」原则,这是 408 与严蔚敏教材的说法。另有一种「最小关键字复写」的定义(
个关键字对应 个指针),部分数据库教材与工程实现采用它,画出来的树不一样。考研做题一律按本文的说法,读工程资料时注意区分。
先动手看一眼
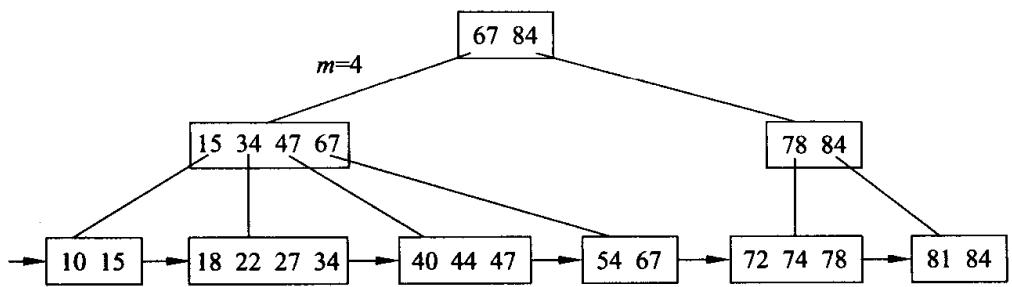
图源:殷人昆《数据结构——用面向对象方法与 C++ 描述》(第 2 版),p487 图 10.39
对着图核验四件事:根 [67 84] 是 2 个关键字对 2 棵子树 ✓;[15 34 47 67] 是 4 个关键字对 4 棵子树,[10 15] 的最大值、34 是 [18 22 27 34] 的最大值)。
全部关键字都出现在叶结点上,而 15、34、47、67、84 在上层又出现了一次——这就是"关键字在内部结点会重复出现"的样子。
查找必须走到叶结点
这是 B+ 树最要紧、也最反直觉的一条:
🔴 即使在内部结点上遇到了等于
的关键字,也不能停。 那个关键字只是索引副本,不带记录指针,停在那里拿不到数据。
所以 B+ 树的每一次查找,不论成功还是失败,都恰好走一条从根到叶的完整路径。
代价是没有"中间层命中"的运气——B 树上查根里的关键字只要 1 次 I/O,B+ 树上永远是
另外,B+ 树有两个头指针:一个指向根(用于随机查找),一个指向关键字最小的叶结点(用于顺序查找、全表扫描)。B 树没有第二个入口——这就是"B+ 树能支持顺序查找而 B 树不能"这个说法的确切含义。
⚠️ 这里的"顺序查找"指的是沿叶链表顺序访问全部关键字,和《顺序查找》那一节讲的
B 树 vs B+ 树
考点几乎全部集中在这张表上:
| 对比项 | B 树 | B+ 树 |
|---|---|---|
| 关键字与子树个数 | ||
| 非根结点关键字数范围 | ||
| 数据存储位置 | 所有结点都可以存数据 | 只有叶结点存数据 |
| 关键字是否重复出现 | 只出现一次 | 内部结点的关键字在叶结点中会再次出现 |
| "叶结点"的含义 | 不含信息的失败结点 | 真实存在、含全部关键字与记录指针 |
| 查找在哪结束 | 可能在任意层命中 | 必须走到叶结点,路径长度恒为 |
| 叶结点链表 | 无 | 有,且另有一个指向最小叶结点的头指针 |
| 范围查询 | 需中序遍历,反复上下移动 | 定位起点后沿叶链表扫描 |
| 同样块大小下的扇出 | 较小(结点里还要放数据) | 较大(纯索引) |
| 分裂时关键字的去向 | 上移到双亲,原结点不再保留 | 复制一份到双亲,叶结点里那份保留 |
⚠️ "叶结点"这个词在两棵树里指的不是一回事:B 树的叶结点是不存在的失败结点,B+ 树的叶结点是真实存在、装着全部关键字的结点。"所有叶结点在同一层"这句话两棵树都成立,但说的是不同的东西。
最后一行"上移 vs 复制"也值得单记:B 树分裂时中间关键字离开原结点搬到双亲,所以它在树中仍然只出现一次;B+ 树的叶结点必须保有全部关键字,所以只能把最大关键字复写一份到双亲当索引——这正是"关键字重复出现"的成因。
它到底适合什么场景
范围查询是分水岭。B+ 树按
再加上扇出优势,就得到了 B+ 树在外存索引上的统治地位。做一次量级估算(磁盘块 4 KB,关键字 4 字节、指针 8 字节、一条数据记录 100 字节):
- B 树内部结点每一项要占
字节 → - B+ 树内部结点每一项只占
字节 →
存
这组数字依赖假设的记录长度,换一组参数结论会变;但方向是稳的:记录越大,B+ 树的扇出优势越明显。
所以典型应用是关系数据库系统的索引——数据量大、要频繁做范围查询(WHERE age BETWEEN 20 AND 30)、要求响应时间可预测,三条全都命中 B+ 树的长处。
⚠️ 要注意 B+ 树并不是万金油,几个常被拿来做干扰项的场景它都不合适:
- 编译器的词法分析:处理的是有限的关键词集合,规模小、在内存里,用散列表或直接匹配就够。
- 网络路由表的快速查找:需要的是"最长前缀匹配",典型结构是 Trie(字典树)一类,不是 B+ 树。
- 操作系统的磁盘空闲块管理:要的是快速找一块空闲区域,用位图或空闲链表,不需要有序索引。
怎么判:数据量大到要放外存、且需要范围查询和顺序访问,才轮到 B+ 树。
插入删除与 B 树的逐项差别(做手工建树题时展开)
B+ 树的插入删除只在叶结点进行,整体流程与 B 树类似(上溢分裂、下溢合并),差别在四处:
| B 树 | B+ 树 | |
|---|---|---|
| 上溢的判定 | 关键字数 | 关键字数 |
| 分裂后两半的关键字数 | ||
| 分裂点关键字的去向 | 上移到双亲,原结点不再保留它 | 复制一份到双亲:双亲中同时包含分裂出的两个结点各自的最大关键字;原关键字仍留在叶结点 |
| 下溢的判定 | 关键字数 | 关键字数 |
删除的一个细节:当叶结点里的最大关键字被删掉时,它在非叶结点里的那个副本不必立即修改——那个值可以继续作为一个"分界关键字"存在,因为它仍然正确地划分了左右子树的范围(只是不再对应任何真实记录)。这是 B+ 树删除比 B 树省事的地方。
走一遍 4 阶 B+ 树:随机查找、范围查询与一次连锁分裂(第一次学、或想手动模拟时展开)
用上面那棵 4 阶 B+ 树(
                      [67  84]
                 /                \
        [15 34 47 67]           [78 84]
        /   |    |   \           /     \
 [10 15]→[18 22 27 34]→[40 44 47]→[54 67]→[72 74 78]→[81 84]
随机查找 44(成功):根 [67 84] 中 [15 34 47 67] 中 [40 44 47] 找到 44,取出记录指针 → 成功。走了 3 层,正好是树高。
随机查找 67(命中了中间层也不能停):根中 [15 34 47 67] 里遇到了等于 67 的关键字——但它只是索引副本、不带记录指针,不能停,[54 67] 找到 67 → 成功。同样走了 3 层。这就是"路径长度恒定"的现场:换成 B 树,第 2 步就命中返回了,路径长度是 2 而不是 3。
随机查找 50(失败):根 → 第 1 棵子树;[15 34 47 67] 里 [54 67] 中没有 50 → 失败。仍然走了 3 层——成功与失败的路径长度完全一样。
范围查询 [18 22 27 34]([40 44 47]:40、44、47 → [54 67]:54 命中,67 已超出上界 → 停止。结果
插入 25:一次连锁分裂
第 1 步:25 应插入 [18 22 27 34],插入后成为 [18 22 25 27 34],5 个
双亲中要同时包含这两个新结点各自的最大关键字,即 25 与 34。34 原本就在,只需插入 25。
第 2 步:双亲变成 [15 25 34 47 67],5 个 [67 84],67 已在,插入 34。
第 3 步:根变成 [34 67 84],3 个
                      [34   67   84]
              /             |            \
      [15 25 34]         [47 67]         [78 84]
      /    |    \         /    \          /    \
[10 15]→[18 22 25]→[27 34]→[40 44 47]→[54 67]→[72 74 78]→[81 84]
逐条核验:根 3 个关键字 ↔ 3 棵子树 ✓;每个非根内部结点关键字数在
第 1 步里 25 同时出现在叶结点和双亲中,就是"复制而非上移"的体现。
复杂度与工程补充
两者的查找都是
空间
数据库中还会区分聚簇索引(叶结点直接存放整行数据)与非聚簇索引(叶结点存放主键值,取完整记录还要再查一次聚簇索引)。这属于工程实现层面,考纲不要求,了解即可。
考点速记
三条结论:
个关键字 ↔ 棵子树(B 树是 );理由是"标签 vs 分隔者"。 - 查找必须走到叶结点,路径长度恒为树高,成功失败都一样。
- 叶结点串成有序链表,另有一个指向最小叶结点的头指针——B 树没有。
这一节在真题里被考过的形式(下方「真题练习」逐题对应):
- B+ 树不同于 B 树的特点是什么:正确答案是"能支持顺序查找"。另外三个选项——结点中含有关键字、根结点至少两个分支、所有叶结点都在同一层——都是两者共有的,所以不能作为区别。做这类题要逐个问"B 树有没有这条",只有 B 树没有的才是答案。
- 哪一条不符合
阶 B 树的定义:答案是"叶结点之间通过指针链接"——那是 B+ 树的特征。同一张表反着考。 - 哪种应用适合用 B+ 树:答关系数据库系统中的索引。干扰项是编译器的词法分析、网络路由表快速查找、操作系统的磁盘空闲块管理,这三个都不需要"外存 + 有序 + 范围查询"。
- B 树性质判断题里的两条对照:"查找某关键字一定要查找到叶结点"对 B 树是错的(内部结点命中就返回),对 B+ 树才是对的——这两句话的主语一换,真假就反过来了。
易错:关键字数与子树数的关系两棵树差 1,别记颠倒。 B 树
个关键字对 棵子树,B+ 树对 棵。连带地,非根结点关键字数范围也差 1。
易错:"所有叶结点在同一层"不是 B+ 树的特有性质,B 树也有。找区别时要盯"叶结点链表""关键字全在叶子""关键字数 = 子树数"这几条。
易错:B+ 树在内部结点遇到等于
的关键字不能停。 那只是索引副本,没有记录指针。
教材出处
- 严蔚敏《数据结构(C 语言版)》(第 2 版)7.3.4 节「B+ 树」,p218: B+ 树是 B- 树的变形树,"严格来讲,它已不符合第 5 章中定义的树了"; 一棵
阶 B+ 树与 阶 B- 树的三条差异—— "有 棵子树的结点中含有 个关键字"; "所有的叶子结点中包含了全部关键字的信息,以及指向含这些关键字记录的指针, 且叶子结点本身依关键字的大小自小而大顺序链接"; "所有的非终端结点可以看成是索引部分,结点中仅含有其子树(根结点)中的最大(或最小)关键字"。 - 同书 p219:B+ 树"通常有两个头指针,一个指向根结点,另一个指向关键字最小的叶子结点", 因此"可以对 B+ 树进行两种查找运算:一种是从最小关键字起顺序查找, 另一种是从根结点开始,进行随机查找";查找时"若非终端结点上的关键字等于给定值,并不终止, 而是继续向下直到叶子结点……不管查找成功与否,每次查找都是走了一条从根到叶子结点的路径"; 插入"仅在叶子结点上进行",分裂后"它们的双亲结点中应同时包含这两个结点中的最大关键字"; 删除"也仅在叶子结点进行,当叶子结点中最大关键字被删除时, 其在非终端结点中的值可以作为一个'分界关键字'存在"。
- 插图:殷人昆《数据结构——用面向对象方法与 C++ 描述》(第 2 版)p487 图 10.39 (按"最大关键码复写"原则组织的 4 阶 B+ 树,与 408 的说法一致)。
相关知识
B 树(定义、高度推导、插入分裂与删除合并的完整流程在那一篇)| 折半查找("二路、静态"的极端)| 分块查找(一级索引;B+ 树的叶链表相当于把"块间有序"贯彻到底)| 拉链法、开放定址法(精确匹配更快但不支持范围查询)| 顺序查找(叶链表上的扫描本质就是它)| 外部排序