Appearance
查找基本概念
2026 大纲 六(一)查找的基本概念。本篇是整章共用的语言与度量工具。
为什么用比较次数当尺子
查找算法的基本动作是关键字之间的比较。同一个算法在不同机器上跑出的时间不一样,但比较次数只取决于表的结构和目标值,与机器无关——所以整章都用比较次数来衡量算法,既能横着比不同方法,又能在纸上算出来。
把它取期望,就是平均查找长度 ASL:
三个符号各有各的坑:
⚠️ 等概率不是默认前提,题目写明"查找概率相同"才成立,此时
🔴
只数关键字比较。 折半查找里取中点的除法、散列里算地址的取模,都不计入。这条边界解释了一个常被问到的现象:散列查找"理想情况下 ASL = 1"而不是 0——即使一次命中,也必须把那个位置上的关键字取出来跟 比一次,才能确认它就是要找的。
还有一条必须先说清:查找成功与查找失败是两个分别分析的过程。它们的比较次数分布不同、平均值不同,混成一个数就全错了。
先动手看一眼
判定树:把两种查找画进同一棵树
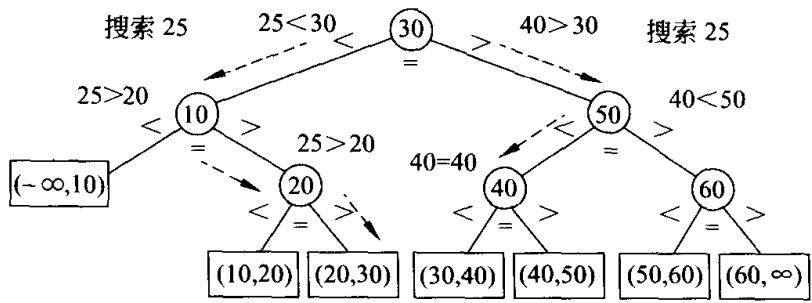
图源:殷人昆《数据结构——用面向对象方法与 C++ 描述》(第 2 版),p306 图 7.3
这张图一次画全了三件事:
- 内部结点(圆)= 一次关键字比较;外部结点(方框)= 失败结点,它是空指针的化身,本身不参与比较。
- 6 个圆对 7 个方框,正好是
个。 - 成功比较次数读结点的层数;失败比较次数读该外部结点父结点的层数(也就是路径上内部结点的个数)。
失败结点为什么恰好
每一段对应一种失败情况,落进同一段的
同一批数据换个方法,判定树的形态就变,而 ASL 就是形态的直接读数:
| 方法 | 判定树形态 | 树高 |
|---|---|---|
| 顺序查找(有序表) | 单支链,每个内部结点只有一个内部孩子 | |
| 折半查找 | 平衡二叉排序树,形态由 | |
| 二叉排序树 | 任意形态,由插入顺序决定 | 最好 |
失败 ASL 的分母到底取多少
成功 ASL 的分母恒为元素个数
一次失败的查找,有多少个互不等价的"入口"? 两个
若走出完全相同的失败路径,就算同一个入口。
| 查找方法 | 失败入口是什么 | 分母 |
|---|---|---|
| 顺序查找(无序表) | 只有一种:扫完全表 | 不必求平均 |
| 顺序查找(有序表) | ||
| 折半查找 | 判定树的外部结点 | |
| 二叉排序树 | BST 的空指针位置 | |
| 分块查找 | 由索引查找法与块内查找法共同决定 | 按定义逐入口数 |
| 散列查找 | 散列函数的值域,即所有可能的初始散列地址 | 值域大小(除留余数法即模数 |
🔴 散列这一行必须单独记,它不适用
。 基于比较的查找从"根"出发,路径由 与表中关键字的大小关系决定,所以失败情况被 个关键字划分;而散列的失败查找从 这个地址开始,能当起点的地址只有 的值域那么多。若 而表长 ,下标 13、14、15 永远不会是任何一次查找的起点,把它们算进平均就错了——分母是模数 ,不是表长 ,更不是元素个数 。
谁在影响 ASL
这是本篇被真题正面问过的角度,答案比直觉更宽:
对散列表来说,装填因子、散列函数、冲突解决策略,三者全都影响 ASL。 没有哪一个是无关的:
- 装填因子
直接决定冲突的概率密度。⚠️ 注意方向——增大装填因子会让 ASL 变差,所以"增大装填因子以提高查找效率"是错的。 - 散列函数决定关键字分布得均不均匀,冲突多不多。
- 冲突解决策略决定冲突发生后要多探测几次,也决定会不会产生堆积。
其中"堆积"(聚集)值得单独说:非同义词争夺同一个地址,使探测序列越接越长。堆积直接影响的是平均查找长度——它不改变存储效率、不改变散列函数、也不改变装填因子(那三个是选项里的干扰项),它改变的只有"要比几次才找得到"。
不等概率:顺序查找可能比折半还快
题目若给出各记录的查找概率
🔴 在比较次数分布固定的前提下,把查找概率大的记录放在比较次数小的位置,ASL 最小。
对顺序查找而言就是按查找概率递减排列(从表头扫,概率最大的放表头)。证明是排序不等式的直接应用:两个序列
小例子:3 个记录,概率
- 按概率递减排列:
- 按概率递增排列:
差了整整 1 次比较。这就是"顺序查找并非一无是处"的实际依据:访问分布高度倾斜时,一张按热度排好的顺序表可能比折半查找还快——真题里就有一道大题走的正是这条路,给了 4 个元素和不等的概率,要求给出比折半查找(ASL = 2.2)更短的方案。
⚠️ 边界:这个优化只对静态表有意义。动态表里概率分布会漂移,维护"按概率排序"的代价通常超过收益。
静态表与动态表
按照是否在查找的同时修改表,查找表分成两类:
| 类型 | 定义 | 典型载体 |
|---|---|---|
| 静态查找表 | 只做查找,不改动表 | 顺序表、有序表、分块索引表 |
| 动态查找表 | 查找的同时可能插入或删除 | 二叉排序树、平衡树、B 树、散列表 |
这一刀为什么重要:静态表可以先花一次代价把数据排好序、建好索引,此后每次查找都享受这份预处理的红利;动态表则必须为"随时可能被改动"付出维护成本,任何依赖全局有序又难以局部修改的结构(比如有序顺序表)都会被插入删除的元素移动代价拖垮。
折半查找只适用于静态表,根子就在这里,不是因为它"算法不支持插入"。
查找表、关键字、查找结果三组术语的完整定义(术语拿不准、或要答名词解释时展开)
查找表(Search Table)是由同一类型的数据元素(或记录)构成的集合。集合中元素之间只有"同属一个集合"这一层松散关系,因此查找表不是一种具体的存储结构,而是一个可以用任何结构去实现的逻辑集合——线性表、树、散列表都可以做查找表的载体。这正是"查找"这一章不讲某种数据结构、而讲一族方法的原因。
关键字(Key)是数据元素中某个数据项的值,用它来标识一个数据元素。
- 主关键字:可以唯一标识一个记录的关键字(如学号、身份证号),不同记录互不相同;
- 次关键字:只能识别若干个记录的关键字(如姓名、班级),允许重复。
当数据元素只有一个数据项时,它的关键字就是元素本身的值——本章所有算例都按这种简化形式写。
查找是指:给定一个值
失败结点为什么恰好 n+1 个——另一种证明(想再换个角度确认就展开)
数指针域:一棵有
与正文里"切区间"的证法结论相同,但切区间那种更好用——它直接告诉你每个失败结点对应哪一段
把上图的两个 ASL 都算出来——完整算例(第一次学、或想手动模拟时展开)
取图中的有序表 mid 向下取整。判定树的形态就是图上那棵:根 30,左子树根 10(只有右孩子 20),右子树根 50(左 40、右 60)。
成功 ASL——逐层统计内部结点:
| 层数 | 该层的关键字 | 结点数 |
|---|---|---|
| 1 | 30 | 1 |
| 2 | 10, 50 | 2 |
| 3 | 20, 40, 60 | 3 |
失败 ASL——逐个外部结点统计,比较次数 = 路径上内部结点数:
| 失败区间 | 路径 | 比较次数 |
|---|---|---|
| 30 → 10 → 空 | 2 | |
| 30 → 10 → 20 → 左空 | 3 | |
| 30 → 10 → 20 → 右空 | 3 | |
| 30 → 50 → 40 → 左空 | 3 | |
| 30 → 50 → 40 → 右空 | 3 | |
| 30 → 50 → 60 → 左空 | 3 | |
| 30 → 50 → 60 → 右空 | 3 |
注意分母是 7 不是 6。
同一张表、两种方法的 ASL 对照(想看清"形态决定 ASL"就展开)
取有序表
顺序查找(从表头扫):成功比较次数依次是
失败区间 6 个,比较次数依次是
折半查找(mid 向下取整):判定树为根 30,左子树根 10(右孩子 20),右子树根 40(右孩子 50)。第 1 层 1 个(30),第 2 层 2 个(10、40),第 3 层 2 个(20、50):
6 个外部结点的比较次数:10 的左空 2 次,20 的左右空各 3 次,40 的左空 2 次,50 的左右空各 3 次:
同一张表、同一套 ASL 定义,只因判定树形态不同,成功 ASL 就从 3 降到 2.2。 这就是"选查找方法"这件事的全部意义。
三条技术路线与按条件选方法的流程(想看全局地图时展开)
所有查找方法都在回答同一个问题:怎样用尽可能少的比较,把候选范围压到 1。只有三条路:
| 路线 | 压缩范围的手段 | 代表方法 | 代价 |
|---|---|---|---|
| 基于比较(线性表) | 每比较一次,排除掉一部分候选 | 顺序、折半、分块 | 折半要求有序 + 随机访问 |
| 基于比较(树表) | 把"排除一部分"固化成树的分支,且能随增删动态调整 | BST、AVL、红黑树、B 树 / B+ 树 | 需要额外指针、需要维护平衡 |
| 不比较(散列) | 由关键字直接算出地址,一步到位 | 散列表 | 冲突不可避免,且丢失有序性 |
这三条路线是递进的:顺序查找每次比较只排除 1 个候选,故
考点速记
三条结论:
- 成功 ASL 的分母恒为
;失败 ASL 的分母是互不等价的失败入口数——基于比较的方法是 ,散列是 的值域大小(模数 )。 只数关键字比较,地址计算、取中点的除法都不计入。 - 不等概率时,按概率递减排列 + 顺序查找可以优于折半查找。
这一节在真题里被考过的形式(下方「真题练习」与《查找算法分析与对比》共用同一批题):
- 影响散列查找 ASL 的因素有哪些:装填因子、散列函数、冲突解决策略——三个全都影响,答"I、II、III"。
- 为提高散列表查找效率可以采取的措施:设计冲突少的散列函数 ✓、处理冲突时避免堆积 ✓,而"增大装填因子"✗——方向反了,装填因子越大 ASL 越差。
- 堆积现象会直接影响什么:答平均查找长度。干扰项是存储效率、散列函数、装填因子,这三个都不受堆积影响。
- 不等概率下重排元素求更短的 ASL(大题):给出 4 个元素和它们不等的查找概率,已知折半查找的 ASL 是 2.2,要求分别在顺序存储和链式存储下给出排列方式、查找方法和新的 ASL。两问的答案都是按概率递减排列 + 顺序查找。
- 各类查找的 ASL 具体计算:散列的成功/失败 ASL、分块查找的最优块长等,分别落在开放定址法、分块查找那几篇。
易错:散列的失败 ASL 分母是散列函数的值域(模数
),不是表长 ,也不是元素个数 。 而表长 11 时,分母是 7。
易错:"增大装填因子能提高查找效率"是反的。 装填因子大意味着表越挤、冲突越多、ASL 越大。
易错:等概率是题目给的条件,不是默认。 题面给出各元素概率时必须用
,不能提 。
教材出处
- 严蔚敏《数据结构(C 语言版)》(第 2 版)第 7 章 查找,7.1 节「查找的基本概念」, p191–p192:查找表、关键字(主/次关键字)、查找成功与不成功、动态查找表与静态查找表 五个术语的定义,以及平均查找长度的定义式
——"为确定记录在查找表中的位置,需和给定值进行比较的关键字个数的期望值"。 - 同书 p196:判定树的外部结点与内部结点的定义,"折半查找时查找失败的过程就是走了一条从 根结点到外部结点的路径,和给定值进行比较的关键字个数等于该路径上内部结点个数"。
- 插图:殷人昆《数据结构——用面向对象方法与 C++ 描述》(第 2 版)p306 图 7.3。
相关知识
顺序查找|折半查找|分块查找(判定树模型的三次应用)| 二叉排序树、平衡二叉树、红黑树(树表路线,原理在树那一章)| B 树、B+ 树(树表路线的外存版本)| 拉链法、开放定址法(失败 ASL 分母与其余方法都不同)| 查找算法分析与对比(本章总结)