Appearance
B 树
2026 大纲 六(六)B 树及其基本操作(B+ 树的基本概念见另一篇)。
换一把尺子:数的不再是比较次数,是磁盘 I/O
内存里比较一次关键字大约几个纳秒,磁盘随机读一次大约几毫秒——相差六个数量级。数据量大到装不进内存时,"比较了几次"就不再是有意义的度量了,真正的成本是读了几个磁盘块。
而一次磁盘 I/O 读进来的是一整个磁盘块(几 KB)。平衡二叉树的一个结点只装一个关键字,等于每读一个磁盘块只利用了其中十几个字节,剩下的全浪费了。
改造思路就一条:把一个磁盘块塞满关键字。一次 I/O 就能把候选范围缩小到
量化一下这笔交易:取
结点内部的比较(在
个关键字里找区间)是在内存中做的,不产生磁盘 I/O。所以即使 取到上千,结点内多比几十次也无所谓——这正是这笔交易划算的原因。
五条性质,以及它们各自在防什么
| 性质 | 它在防什么 | |
|---|---|---|
| (1) | 每个结点至多 | 上界:一个结点要装得进一个磁盘块 |
| (2) | 根若不是叶结点,至少 2 棵子树(1 个关键字) | 根不受下界约束,否则树没法从 1 个关键字长起来 |
| (3) | 除根外所有非叶结点至少 | 下界:强制每个结点至少半满——B 树效率的命根子 |
| (4) | 所有叶结点在同一层且不带信息(失败结点) | 绝对平衡:任何一次查找的 I/O 次数都相同 |
| (5) | 结点内关键字递增有序; | 有序性:结点内可顺序或折半定位子树 |
性质(3)那条下界是全篇的重点。没有它,B 树可以退化成每个结点只有 1 个关键字的二叉树,树高失控;有了它,树高才有一个
所以非根结点的关键字个数被夹在一个区间里:
"叶结点"在 B 树里指的是不存在的失败结点
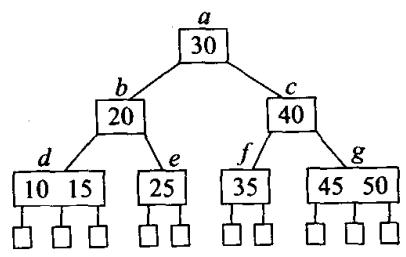
图源:殷人昆《数据结构——用面向对象方法与 C++ 描述》(第 2 版),p478
图上最底下那排空方框就是"叶结点"——它们并不真实存在,指向它们的指针都是空的,引入它们只是为了便于分析查找性能。所以:
🔴 性质(3)里的"非叶结点"= 全部含关键字的结点,最底层那一排也算在内。
这里有两套必须拆开的术语。严蔚敏教材的原话是"除根之外的所有非终端结点至少有
⚠️ 千万不要读成"终端结点不受下界约束"——推最大高度时,正是靠"每个终端结点也至少有
由此还得到一个直接可用的事实:
先动手看一眼
高度:先把规定说清,再套公式
计数题是这一节考得最多的形式,而算错的第一大原因不是公式,是"高度"怎么数:
🔴 408 说的"高度"不含失败结点那一层。 "高度为 2 的 5 阶 B 树"指的是两层含关键字的结点(根一层、终端结点一层),失败结点不算。
这条规定定了,两个界就好用了:
但做计数题时不要背公式,要逐层数——公式只在"给了
求最少关键字:每个结点都取下限。
- 第 1 层(根):1 个关键字、2 棵子树(根的特权)。
- 第 2 层起:每个结点
个关键字、 棵子树。
于是结点数逐层是
求最多关键字:每个结点都取上限,每结点
三个算过的例子,都是真题的原题设定:
| 题设 | 逐层数 | 答案 |
|---|---|---|
| 高度 2 的 5 阶 B 树,关键字最少 | 根 1 个 + 2 个孩子各 | |
| 高度 5 的 3 阶 B 树,关键字最少 | 3 阶下界是每结点 1 个关键字、2 棵子树。结点数 | |
| 15 个关键字的 4 阶 B 树,含关键字的结点最多 | 要结点多就让每结点关键字少。4 阶非根下界是 1 个关键字、2 棵子树 → 每结点都只放 1 个 |
最后一行值得多看一眼:每个结点只放 1 个关键字、带 2 棵子树,这棵 4 阶 B 树长得跟满二叉树一模一样(
还有一类问法给的条件更偏,比如"高度 3 的 3 阶 B 树,第 2 层有 4 个关键字,结点个数最多"。这时要分两步凑:
- 让第 2 层的结点数尽量多。 3 阶每结点最多 2 个关键字,4 个关键字最少要 2 个结点;但要"结点最多"就该拆散成 3 个(2+1+1),这需要根有 3 棵子树即 2 个关键字——3 阶允许(上限就是 2 个)✓。
- 第 3 层的结点数 = 第 2 层各结点的子树数之和 = 关键字数 + 结点数
。
总计
查找:命中就返回,不一定走到底
从根开始在结点内找
🔴 B 树的所有结点都存关键字,所以查找在内部结点命中就直接返回,不必下到最底层。 这一条被真题作为错误命题考过("查找某关键字一定要查找到叶结点"是错的),而且它正是 B+ 树与 B 树的关键差异——B+ 树的关键字全在叶子,那边才是每次都得走到底。
c
typedef struct { BTNode *node; int index; int found; } SearchResult;

SearchResult BTreeSearch(BTNode *root, int key) {
    BTNode *p = root, *parent = NULL;
    int i = 1;                       // 必须初始化:空树时循环一次都不进
    while (p != NULL) {
        for (i = 1; i <= p->keyNum && key > p->keys[i]; i++)   // 停在第一个不小于 key 的关键字
            ;
        if (i <= p->keyNum && key == p->keys[i])
            return (SearchResult){p, i, 1};
        parent = p;
        p = p->children[i - 1];      // key < keys[i],进入 K_i 的左子树 P_{i-1}
    }
    return (SearchResult){parent, i, 0};      // 走到失败结点,返回插入位置
}
children[i-1] 为什么能统一:循环退出时若 children[i-1] ✓。两种情况表达式统一,不需要分支。
插入:查找失败停在哪,就插在哪
- 先查找,确定新关键字应插入的终端结点;插入后若关键字数
,直接完成; - 若达到
(上溢):取第 个关键字为分裂点,左边留在原结点、右边移入新建结点,分裂点本身上移到双亲(新结点指针也插进双亲); - 双亲若也上溢则继续向上分裂;根分裂时新建一个只含 1 个关键字的根,树高加 1。
🔴 插入动作永远发生在终端结点——查找失败必然停在终端结点,中间层的关键字只能由下层分裂上移产生。
⚠️ 但这里有个措辞陷阱,真题正面考过:"插入的新关键字最终位于叶结点中"是错的。新关键字确实先插进终端结点,可一旦引发分裂,上移的那个中位数如果恰好就是新插入的关键字,它就跑到内部结点去了。"插在终端结点"说的是动作,"最终待在终端结点"说的是结果,两者不等价。
为什么分裂点必须取第
⚠️
删除:先归约到终端结点,再先借后合并
第一步:把删除位置归约到终端结点。
| 待删关键字在哪 | 处理 |
|---|---|
| 终端结点 | 直接删,再检查是否下溢 |
| 非终端结点 | 用直接前驱(左子树最右下)或直接后继(右子树最左下)替换它,转化为"删那个终端结点里的前驱/后继" |
为什么用前驱或后继:
由此也得到一条被考过的结论:删除操作一定会导致终端结点发生变化。删终端结点里的关键字自不必说;删内部结点的关键字,也要先用终端结点里的前驱/后继替换,最后总归是从终端结点里少了一个。
第二步:处理下溢(关键字数
| 策略 | 触发条件 | 操作 |
|---|---|---|
| 向左兄弟借 | 左兄弟关键字数 | 双亲的分隔关键字下移到当前结点,左兄弟的最大关键字上移到双亲 |
| 向右兄弟借 | 右兄弟有富余 | 双亲的分隔关键字下移,右兄弟的最小关键字上移 |
| 合并 | 左右兄弟都恰好等于下界 | 当前结点 + 双亲的分隔关键字 + 一个兄弟拼成一个结点;双亲少一个关键字,可能连锁向上;根被掏空则删掉空根、树高减 1 |
借为什么必须"经双亲中转":以向右借为例,右兄弟的最小关键字比双亲的分隔关键字大,直接搬过来会破坏"当前结点的关键字全部小于分隔关键字"这条有序性。
合并后不会上溢:
🔴 树长高的唯一方式是根分裂,变矮的唯一方式是根被合并掏空。 除了这两种情形,B 树的高度在任何插入删除中都不变——这正是"所有叶结点始终在同一层"得以维持的机制。
结点结构与实现细节(要照着敲代码时展开)
结点结构:
┌──┬────┬──┬────┬──┬─ ... ─┬──────┬──┐
│P₀│ K₁ │P₁│ K₂ │P₂│       │Kₙ    │Pₙ│
└──┴────┴──┴────┴──┴─ ... ─┴──────┴──┘
c
#define M 5  // 5 阶 B 树:每个结点最多 4 个关键字、5 棵子树

typedef struct BTNode {
    int keyNum;                      // 当前关键字个数 n
    int keys[M];                     // keys[0] 不用,实际用 keys[1..M-1]
    struct BTNode *children[M + 1];  // 子树指针 P0..Pn
    struct BTNode *parent;           // 指向双亲,删除时向上回溯要用
} BTNode;
keys[0]空出不用,是为了让存在 keys[i],这样的左子树就是 children[i-1]、右子树就是children[i],下标关系最简单。parent不是定义要求的,是实现删除时向上传播下溢的便利。
实际应用中
高度上下界的完整推导与验算(想弄懂那两个对数式怎么来的就展开)
最小高度:每个结点尽可能满。 每结点装
最大高度:每个结点尽可能空。 这里要用失败结点:
验算(
| 最少关键字数 | 最多关键字数 | |
|---|---|---|
| 1 | 1 | 4 |
| 2 | 5 | 24 |
| 3 | 17 | 124 |
复杂度为什么写成
| 操作 | 磁盘 I/O 次数 | 结点内比较 | 说明 |
|---|---|---|---|
| 查找 | 每层 | 每层读一个结点,正好一次 I/O | |
| 插入 | 最坏 | 同上 | |
| 删除 | 最坏 | 同上 |
插入的连环分裂演算(第一次学、或想手动模拟建树时展开)
第 1~4 个:结点未满,直接放 → [20, 30, 50, 52]
插入 60 → 上溢,根分裂,树高 1 → 2:结点变成
        [50]
       /    \
[20,30] [52,60]这一步就是"树长高的唯一方式是根分裂"的现场:新根只有 1 个关键字(性质(2)允许根只有 1 个,这正是为什么根要单列一条)。而且分裂是向上长的,所以两个孩子仍在同一层——绝对平衡自动被保持。
插入 25:落在
        [50]
       /    \
[20,25,30]  [52,60,68,70]
插入 90 → 第二次分裂,这次上移到已有的根:
      [50, 68]
     /    |    \
[20,25,30] [52,60] [70,90]
根从 1 个关键字变成 2 个,未超过 4,分裂到此为止,树高不变。
对照两次分裂:只有根自己上溢时树才长高;子结点上溢只是把一个关键字塞进双亲,除非双亲也被塞爆,否则树高不动。
删除的五步连环演算:借、合并、前驱替换、掏空根(想把三种情况一次串完就展开)
5 阶 B 树(非根结点 2~4 个关键字,根至少 1 个),初始:
            [30, 60]
           /    |    \
   [10, 20] [40, 50] [70, 80, 90]
删终端结点里且删完不下溢的(比如删 90)直接删,没什么可讲。有意思的是下面这条连环:
第 1 删:删 50 → 借右兄弟。
            [30, 70]
           /    |    \
   [10, 20] [40, 60] [80, 90]
注意不是把 70 直接搬给
——借兄弟必须经双亲中转(60 下来、70 上去),否则会破坏"双亲关键字分隔左右子树"的有序性。
第 2 删:删 60 → 合并。
         [30]
        /    \
  [10, 20] [40, 70, 80, 90]
双亲只剩
第 3 删:删 30 → 非终端关键字,前驱替换。 30 在根,不能直接删:用直接前驱(左子树最右下)20 替换 30,转化为"删终端结点
         [40]
        /    \
  [10, 20] [70, 80, 90]
第 4 删:删 20 → 又一次借。
         [70]
        /    \
  [10, 40] [80, 90]
第 5 删:删 10 → 合并掏空根,树高减 1。
[40, 70, 80, 90]数"能构成多少棵不同的 B 树"(遇到这类计数题时展开)
有一类计数题问:给
第一步先把问题化简:关键字互不相同,而 B 树是有序的——只要树的"形状"(每个结点装几个关键字 + 父子结构)定了,把关键字按大小顺序填进去的方式就唯一。所以
第二步按高度分类枚举。 以"7 个关键字、4 阶 B 树"为例(4 阶:每结点 1~3 个关键字,根也是 1~3 个):
高度 1(根 + 一层终端结点):设根有
| 满足 | 种数 | ||
|---|---|---|---|
| 2 | 6 | 1 | |
| 3 | 5 | 6 | |
| 4 | 4 | 1 |
小计 8 种。⚠️ 分布是有序的——
高度 2:根
合计
这类题的关键不在技巧,在不重不漏地枚举:先按高度分层,每层按"根有几个孩子"分类,再解一个带上下界的整数分拆。别忘了分布是有序的,这是最容易漏掉一半答案的地方。
考点速记
三条结论:
- 非根结点关键字数
,子树数 = 关键字数 + 1;根的下界是 1 个关键字。 - 408 说的"高度"不含失败结点层。 计数题逐层数,别背公式。
- 树长高只有根分裂,变矮只有根被掏空。
这一节在真题里被考过的形式(下方「真题练习」逐题对应):
- 关键字数的极值:给高度和阶数问关键字最少多少(如高度 2 的 5 阶 → 5 个;高度 5 的 3 阶 → 31 个)。每个结点都取下界,根取 1 个关键字 2 棵子树,逐层数。
- 结点数的极值:给关键字总数问含关键字的结点最多多少(如 15 个关键字的 4 阶 B 树 → 15 个结点)。要结点多就让每结点关键字少,取下界即可。
- 带附加条件的结点计数:如"高度 3 的 3 阶 B 树,第 2 层有 4 个关键字,结点数最多"。先把第 2 层拆成尽可能多的结点,再用"子树数 = 关键字数 + 1"逐结点累加出第 3 层。
- 能构成多少棵不同的 B 树:给
个不同关键字问不同 阶 B 树的个数。形状定了填法就唯一,所以是数形状;按高度分类、按根的孩子数分支、解有上下界的整数分拆,分布有序。 - 依次插入后根结点含哪些关键字:给一串关键字依次插入初始为空的 B 树,问根里最后剩什么。老老实实一步步插、该分裂就分裂,分裂点取第
个。 - 删除后某个结点的关键字序列:删一个关键字后问"最右叶结点是什么"或"根结点不可能是哪个序列"。先借后合并的顺序不能颠倒;问"不可能"时要把借左、借右、合并各种走法都试一遍,四个选项里三个是某种合法走法的结果。
- 定义与性质判断:哪一条不符合
阶 B 树定义("叶结点之间通过指针链接"是 B+ 树的特征,不是 B 树);四个命题的真伪——"插入可能增加树高"✓、"删除一定导致终端结点变化"✓、"查找一定要查到叶结点"✗、"插入的新关键字最终位于叶结点中"✗。
易错:"高度"不含失败结点层。 把失败结点那层算进去,"高度 2"会被当成只有一层含关键字的结点,答案直接错。
易错:"插入的新关键字最终在终端结点里"是错的。 插入动作发生在终端结点,但分裂时上移的中位数若正是它,它就进内部结点了。
易错:"查找一定要走到最底层"是错的。 B 树每个结点都存关键字,内部结点命中就返回;那是 B+ 树才有的性质。
易错:分裂点是第
个,不是"看着居中的那个"。 为偶数时两者不同。
易错:删除下溢时先借后合并,顺序固定。 兄弟有富余却直接合并,得到的树是错的。
教材出处
- 严蔚敏《数据结构(C 语言版)》(第 2 版)7.3.3 节「B- 树」,p210:
阶 B- 树定义的五条性质——"树中每个结点至多有 棵子树"; "若根结点不是叶子结点,则至少有两棵子树"; "除根之外的所有非终端结点至少有 棵子树"; "所有的叶子结点都出现在同一层次上,并且不带信息,通常称为失败结点 (失败结点并不存在,指向这些结点的指针为空。引入失败结点是为了便于分析 B- 树的查找性能)"; 以及结点结构图与关键字个数范围 。 - 同书 p211:B- 树"平衡、有序、多路"三个特点,以及查找过程的举例。
- 同书 p213:最大高度的推导——"第
层至少有 个结点。 而 层的结点为叶子结点。若 阶 B- 树中具有 个关键字, 则叶子结点即查找不成功的结点为 ",得 。 - 同书 p216:算法 7.9 B- 树的插入——"以该结点的第
个关键字 为拆分点,将该结点分成 3 个部分", 以及"由于根结点无双亲,则由其分裂产生的两个结点……构成一个新的根结点。 此时,B- 树的高度增加 1"。 - 插图:殷人昆《数据结构——用面向对象方法与 C++ 描述》(第 2 版)p478。
相关知识
B+ 树(关键字全部下沉到叶结点并链成有序链表)| 二叉排序树、平衡二叉树、红黑树(内存版本,原理在树那一章)| 折半查找|分块查找| 外部排序|开放定址法